仿真图太干净,AI 反而看不懂真显微镜:Aalto 用风格迁移,主动把训练数据“弄脏”
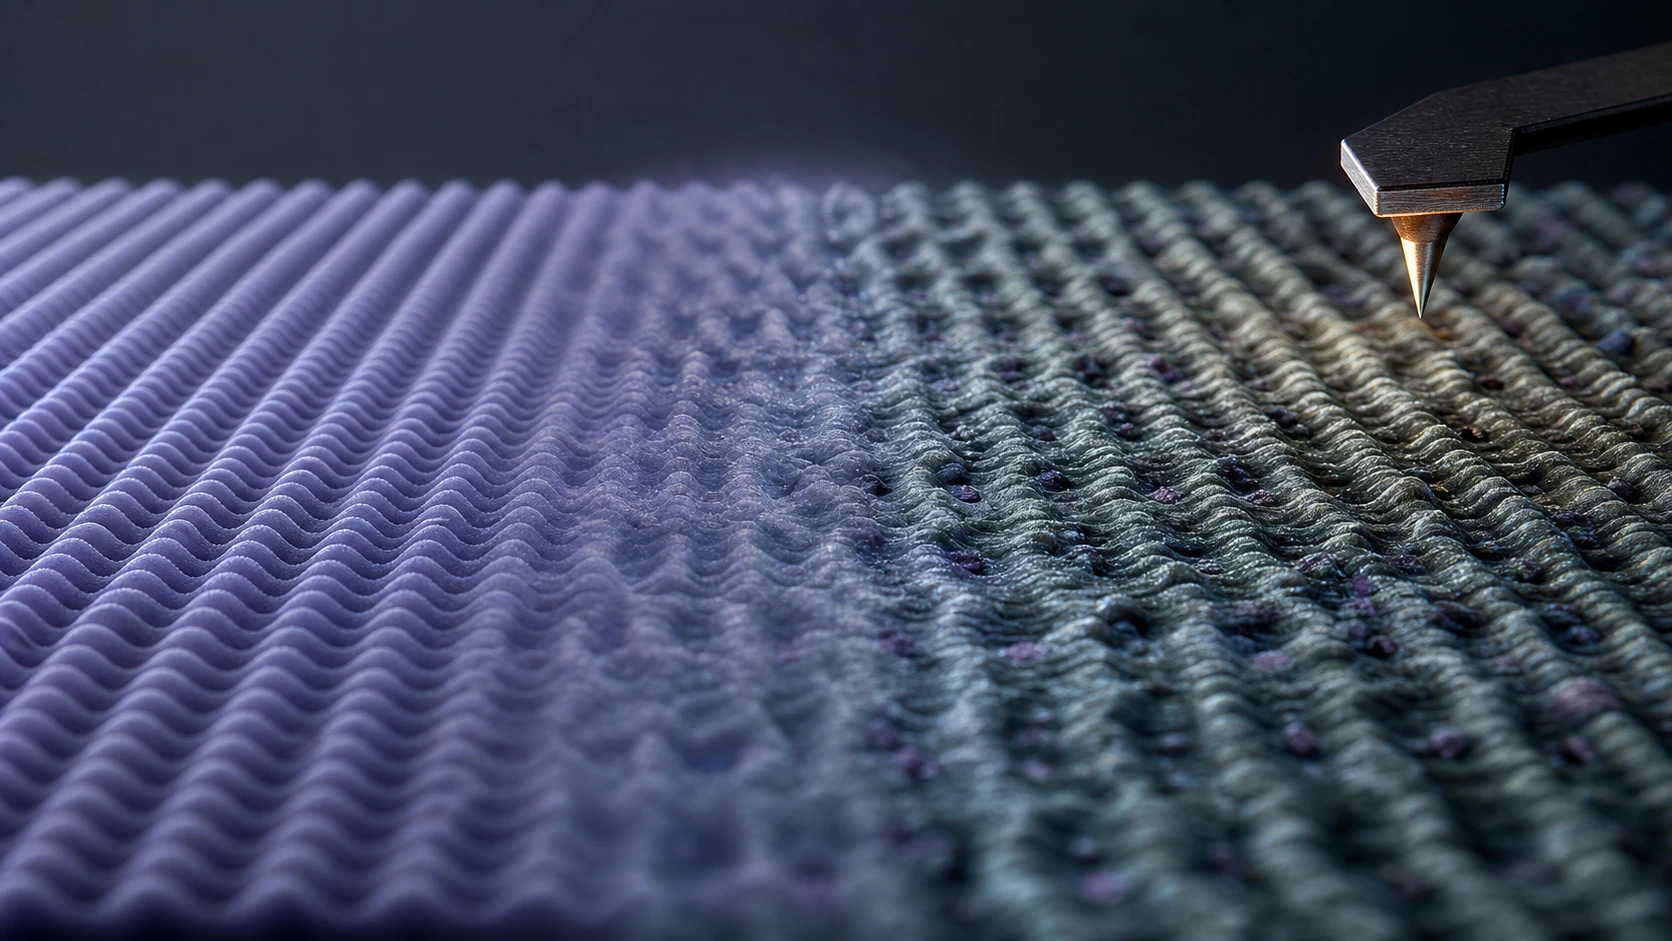
原子力显微镜的模拟图干净、便宜、标签齐全,真实实验图却带着探针和环境留下的纹理。风格迁移要补的不是美感,而是两个知识世界之间的口音。
仿真图太干净,AI 反而看不懂真显微镜:Aalto 用风格迁移,主动把训练数据“弄脏”
一台电脑可以在夜里生成成千上万张原子力显微镜模拟图。
每张图都有清楚来历:表面结构是什么,探针距离是多少,哪些位置对应怎样的局部属性。它们干净、整齐、标签完备,像语言教科书里的标准录音。拿这些图训练机器学习模型,准确率很容易显得漂亮。
第二天,实验员把一张真实图放进模型。图像里有漂移、有噪声,探针尖端的微小变化会改变亮暗,真实表面还可能出现模拟没有包含的结构。模型忽然像一个只听过播音腔的人走进菜市场:每个字似乎都认识,整句话却听不懂。
2026 年 7 月 27 日,Aalto University 等机构的研究者在 npj Computational Materials 发表一项工作,尝试用“风格迁移”缩小原子力显微镜模拟图与实验图之间的差距。这个词听上去像让照片改成油画,容易让人误以为科学家在给显微图加滤镜。
其实他们面对的是科学 AI 一个越来越普遍的难题:
当训练数据来自一个可控、完美、标签齐全的模拟世界,而任务发生在一台有脾气的真实仪器里,模型缺的往往不是更多同类样本,而是理解两个世界怎样生成差异。
这里的“风格”,不是审美。它是探针、设备、表面和环境共同留下的统计口音。
AFM 拍的不是原子的证件照,是一次测量的结果
原子力显微镜并不像普通相机那样靠光把物体拍下来。它用极尖的探针靠近样品表面,测量探针与表面之间的作用力。高分辨率非接触模式中,探针末端甚至可以功能化,让研究者分辨分子内部和原子级结构。
最终图像并不是“表面本来长这样”的直接复制。它是样品结构、探针形状、尖端化学、扫描高度、振动响应、电子与力学相互作用以及后处理共同形成的测量结果。同一个表面换一根探针、换一个高度,纹理就可能变化。
这不意味着图像不真实。天气预报图也不是天空本身,X 光片也不是骨骼本身;只要生成关系被理解、条件被记录,间接表征仍然可以提供可靠知识。麻烦在于,机器学习特别容易把“图像长相”与“结构事实”混在一起。
为了获得大量训练数据,研究者常用探针粒子模型模拟 AFM 图。模拟速度快,也能为每一张图自动附上结构标签。理论上,模型可以从图像预测分子结构、局部属性分布甚至分子图。可模拟必须选择哪些物理细节被保留、哪些噪声被忽略。
模拟图通常比实验图完美。它们没有实验室地板的微振、电子噪声和慢漂移,也不必面对一根刚刚发生微小改变的探针。机器学习模型若在这些图上长大,可能学会“完美世界里亮斑的形状”,却没有学会真实世界中同一结构怎样变形。
计算机视觉把这种问题称作 domain gap,域差。自动驾驶模型若只在晴天仿真道路训练,到了雨夜会失灵;工业视觉若只看无划痕的合成零件,产线油污就会被当成缺陷。AFM 的特殊之处,是域差不只来自相机噪声,还来自测量过程本身参与了图像生成。
被“弄脏”的只能是训练图,不能是实验证据
研究团队的路线,是让大量可标注的模拟图学会更接近实验图的外观分布。风格迁移模型观察两类图的统计差异,再给模拟图加入实验域中常见的纹理与变化。结构标签仍来自模拟,外观却不再像从真空里打印出来。
这样做的直觉很简单:既然真实实验图昂贵、稀少且很难逐像素标注,就不要等待一座完美实验数据库;先把便宜的模拟数据变得更像模型将来真正遇到的输入。
论文报告,风格迁移缩小了模拟与实验 AFM 图之间的差距,并通过局部结构属性分布的比较,展示它对结构发现模型预测表现的改善。研究重点不只是让图片“看起来更真”,而是看下游模型能否在缺少标注实验数据时更有效工作。
这里有一个极重要的顺序:风格转换发生在训练与数据增强环节,实验图仍应作为需要解释的真实观测。不能因为生成图有实验质感,就把它当成实验数据;也不能把模型补出的纹理画进论文图后,称为显微镜看见的结构。
生成式模型在科学中的合法位置,取决于责任链是否清楚。它可以帮助模型跨域、构造假设、补足训练分布;它不能偷偷替仪器发言。
论文网页还注明,当前上线的是未经最终编辑的版本,正式排版前可能存在需要修订的错误。早期版本在 2025 年已上传 arXiv,7 月的新闻增量是同行评议期刊正式发表。报道不能把它写成“本周突然诞生”的方法,但可以讨论它为什么在今天的科学 AI 中变得更重要。
图越像真的,人越容易信,这正是风险
风格迁移最直观的优点,也正是它的风险:图像越像真的,人越容易相信它。
假设实验域里常见某种条纹来自探针状态。模型学会把类似条纹加进模拟图,确实可能提高下游鲁棒性。但若某次真实实验出现罕见的新结构,它的纹理恰好偏离训练分布,域适配也可能把有意义的异常当成风格差异。
另一个风险是“内容泄漏”。理想的风格迁移只改变成像特征,不改变底层结构。现实中的生成模型未必知道哪一笔属于风格,哪一笔携带化学或几何信息。如果转换过程增删了局部特征,下游模型可能在一份看似更真实的训练集上学习被悄悄改写的答案。
因此,科学风格迁移不能只靠人眼评价“像不像”。需要检查结构标签是否保持、不同局部属性的分布是否一致、哪些类别改善、哪些类别退化,并在来自不同探针、不同实验室和不同材料的外部数据上验证。
论文使用局部结构属性分布进行比较,正是在避开纯视觉说服。但一项方法论文不可能一次覆盖所有仪器漂移和表面体系。它提供的是特定 AFM 任务中的证据,不是“风格迁移解决科学仿真—现实差距”的通用许可证。
对于研究团队,最好的模型也许不是把域差藏得最深,而是把剩余差异显示得最清楚。若系统能告诉实验员“这片区域远离训练分布”“这个预测对探针风格敏感”,它就不只给答案,也保留了继续怀疑的入口。
一百万张仿真图,可能只是重复了一百万次同一个世界观
科学 AI 常把问题表述成数据量不足:实验太贵,所以需要更多数据。这个判断没有错,却不完整。
一百万张从同一套假设生成的模拟图,可能只是一百万次重复同一个世界观。数据量增加,覆盖的物理机制却没有增加。模型在模拟测试集上不断进步,也可能只是越来越熟悉模拟器的习惯。
AFM 风格迁移把焦点从“有多少张图”移到“这些图从哪里来”。训练数据与测试数据不仅数量不同,生成过程也不同。真实仪器没有义务服从模拟器的整洁。
这对更广泛的科学计算有启发。气候模型与观测站、机器人仿真与真实摩擦、芯片数字孪生与制造偏差、望远镜合成图与天空数据,都存在自己的域差。每个领域都需要先写清楚:哪些差异只是设备和环境造成的可适配外观,哪些差异恰恰是待发现的新现象。
如果分界没写清楚,生成模型可能让训练数据更“像真”,同时让科学家更难看见哪里不真。
这也是为什么“AI 代替实验”的口号如此粗糙。模拟的优势来自可控和可标注,实验的价值来自世界会反驳我们的假设。科学进步不该把二者变成一场淘汰赛,而应建立一条往返路线:模拟提出结构,实验制造摩擦,模型学习差异,新的异常再迫使模拟修正。
偏离标准发音,不等于没有内容
我们说一张图有“实验口音”,容易把噪声写得浪漫。实际实验员知道,很多口音非常麻烦:一根探针污染、一段漂移、一次振动,就可能耗掉数小时。没有必要把每个伪影都赞美成信息。
但口音这个比喻有一个用处:它提醒我们,偏离标准发音不等于没有内容。一个只在标准数据上训练的系统,常把差异当作错误;经验丰富的实验者却会问,差异来自仪器、样品,还是一种此前没见过的结构。
风格迁移试图把一部分实验经验前移到训练阶段。它没有把经验变成几条人工规则,而是让模型从图像分布中学习。这个过程若做得好,可以减轻人每次从头校正域差的负担;若做得不好,也可能把经验压成不透明的生成习惯。
未来真正可靠的科学 AI,不应只有一个“预测结构”的按钮。它还需要保存原始实验图、记录探针与扫描条件、展示转换前后差异、报告不确定性,并允许研究者追问模型究竟依赖了哪些局部特征。
可追溯性不如准确率醒目,却是科学工具与消费滤镜的分界。
教 AI 听懂口音,还要教它在没听懂时停下来
这项研究最容易被包装成一个熟悉故事:AI 把模糊显微图变清楚,自动发现原子结构。论文实际上更克制。它没有凭空恢复一张“真实原子照片”,而是在标注实验数据稀少时,用风格迁移增强模拟数据,让下游结构属性模型更能面对实验图。
这不是替世界补写答案,而是让训练环境少一点洁癖。
下一步需要的证据也很明确:不同实验室、不同探针和不同表面材料能否复现改善?转换是否保存所有与结构相关的局部信息?模型遇到真正新颖结构时会报警还是强行归类?人类专家能否从不确定性与转换痕迹中审计它?
显微镜从来不是一扇完全透明的窗。它是一种精密的对话:探针向表面发问,表面以作用力回答,仪器把回答翻译成图像,研究者再把图像翻译成结构。
现在,AI 加入这条翻译链。它可以帮助听懂口音,也可能在不知不觉中把陌生句子改成熟悉表达。
所以我们不只需要模型更会听,还需要它在没听懂时诚实停下来。
实验图里最宝贵的部分,有时不是它多像训练数据,而是它坚持不像。
参考资料清单
- 《npj Computational Materials 论文》,2026 — https://www.nature.com/articles/s41524-026-02243-2
- 《arXiv 早期版本》,2025 — https://arxiv.org/abs/2509.02240
- Aalto University 论文记录,2026 — https://www.aalto.fi/en/department-of-applied-physics/full-list